详解 MySQL 存储过程:从创建、调用到删除完整指南
本文通俗易懂讲解MySQL存储过程,附带大量可直接运行实战SQL示例。包含DELIMITER分隔符、IN/OUT/INOUT三种参数用法、变量声明、IF判断、WHILE循环、异常捕获,完整演示存储过程创建、查看、CALL调用与删除操作,分析存储过程优缺点和开发常见坑。
很多刚接触 MySQL 的开发者,写业务时会反复复制一大段相同的 SQL。比如每月统计订单、批量更新用户状态、汇总报表数据,每次都要在代码里拼接多条SQL,来回和数据库交互。不仅代码冗余,还会产生较多网络开销。MySQL 存储过程,就是用来解决这类重复数据操作的方案。
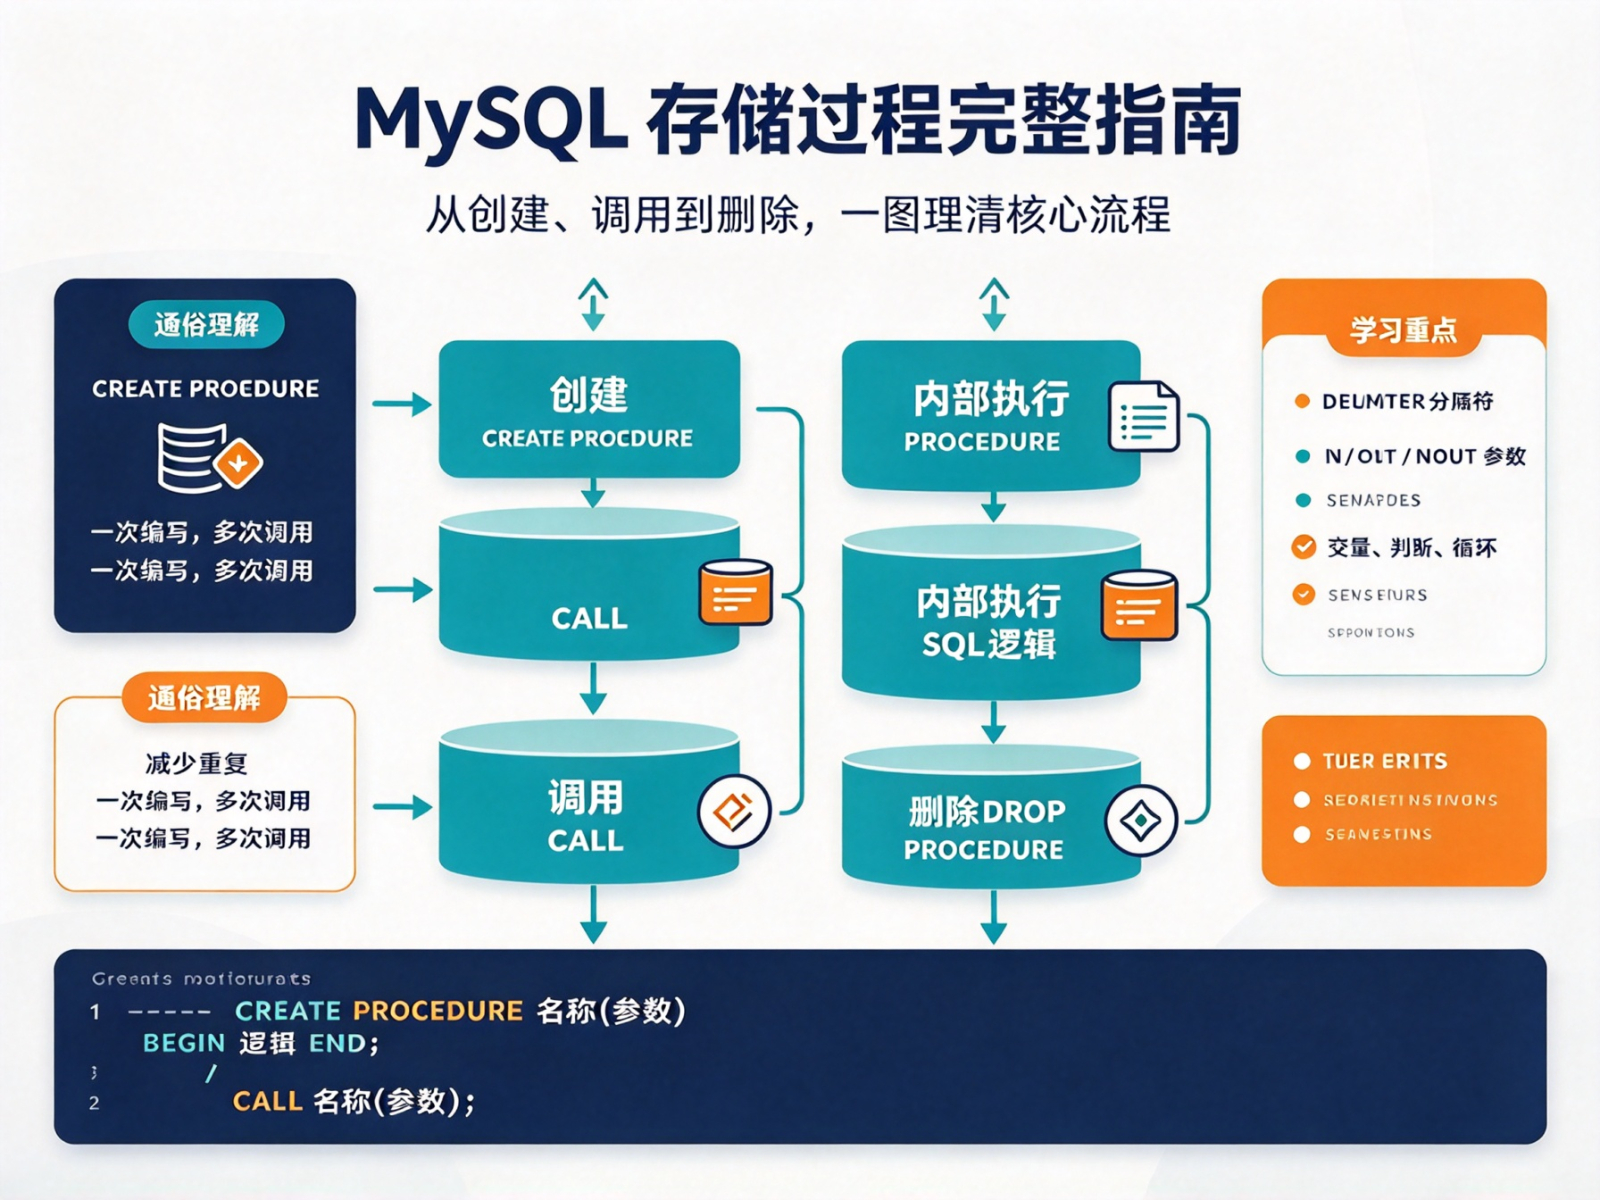
简单一句话理解:存储过程就是存放在 MySQL 服务器里面,提前写好的一段SQL脚本,给它起个名字,以后想用直接调用这个名字就行。
它把多条SQL、变量、判断、循环打包在一起,保存在数据库中。应用程序不需要每次把一长串SQL传给数据库,只需要发送一条调用指令,数据库就会执行内部全部逻辑。
很多人会混淆存储过程和函数:存储过程没有返回值,使用 CALL 调用,可以返回多个结果集;函数必须有返回值,可以直接嵌入SELECT语句中使用。
一、写存储过程必须懂:分隔符 DELIMITER
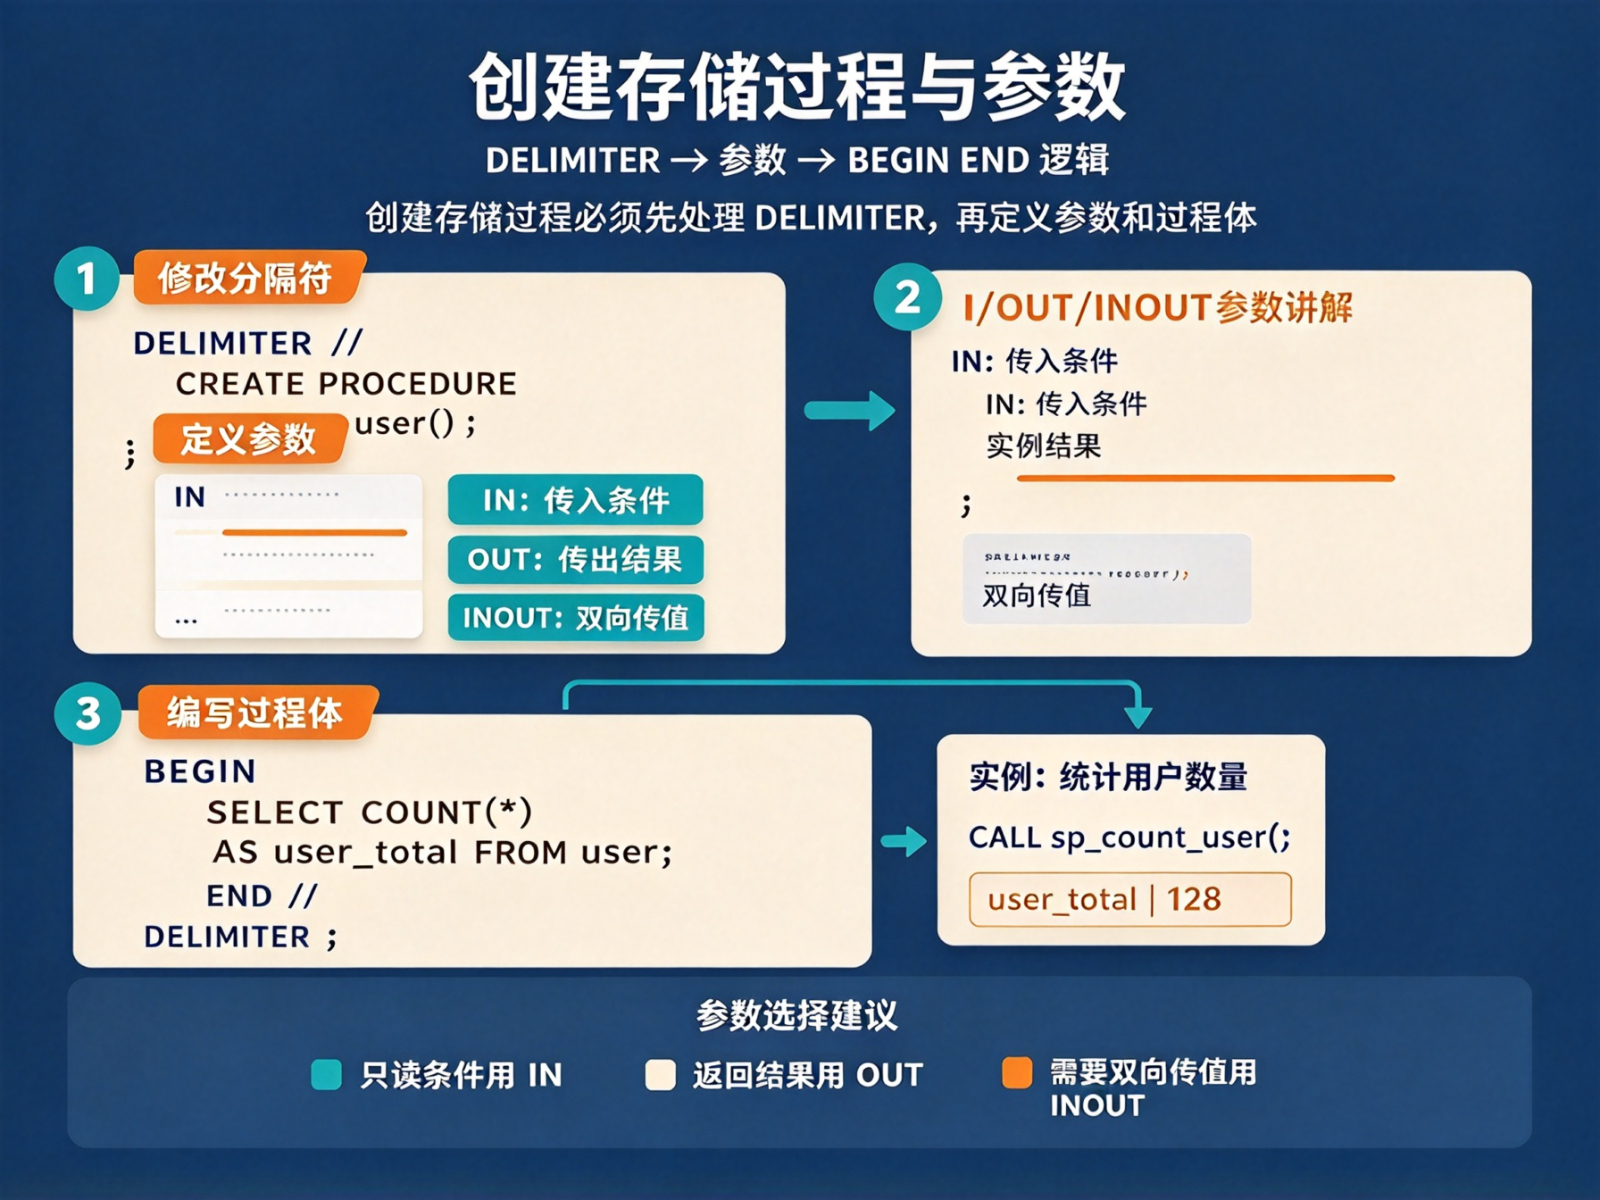
MySQL 默认把英文分号 ; 当作一条SQL的结束标记。
普通单条SQL没问题,但是存储过程内部会写很多语句,每一句都带分号。如果不修改结束符,MySQL读到过程体内第一个;,就会误以为整条创建语句已经结束,直接报错。
所以写存储过程固定操作:
先用
DELIMITER修改语句结束符号(常用//或者$$)编写 CREATE PROCEDURE 代码
存储过程写完,再用
DELIMITER ;恢复默认分号
示例:
-- 修改结束符为 //
DELIMITER //

-- 这里写存储过程代码
CREATE PROCEDURE sp_test()
BEGIN
 SELECT 'hello mysql procedure';
END //

-- 恢复默认结束符
DELIMITER ;
这个是新手踩坑第一名,几乎所有写存储过程的初学者,都会忘记修改分隔符,导致创建失败。
二、创建存储过程语法详解 + 实战例子
基础创建语法:
CREATE PROCEDURE [IF NOT EXISTS] 存储过程名(参数列表)
BEGIN
 -- 这里写过程体,多条SQL逻辑
END
IF NOT EXISTS 可选,作用:如果同名存储过程已经存在,不会抛出错误,避免脚本执行中断。
存储过程三种参数(通俗讲解)
参数格式:参数方向 参数名称 数据类型,一共三类:
IN:输入参数(默认类型):外部传值进来,存储过程内部读取使用。过程内部修改这个变量,不会影响外面原始的值。相当于“只读传入”。
OUT:输出参数:只用来把计算结果传回外部。调用的时候必须传一个变量,存储过程内部给这个变量赋值,执行结束后外部可以读取结果。相当于“结果出口”。
INOUT:输入输出参数:既能传入初始值,存储过程内部修改之后,又把修改完的值返回出去。相当于双向通道。
开发小建议:参数名尽量加前缀 p_,避免和数据表字段重名,引发查询条件异常。
实例1:无参数存储过程
场景:有一张用户表 user,需要快速查询全部用户总数。每次统计都要写SELECT,封装成存储过程。
DELIMITER //
CREATE PROCEDURE sp_count_user()
BEGIN
 -- 查询用户总数
 SELECT COUNT(*) AS user_total FROM `user`;
END //
DELIMITER ;
解释:这个存储过程没有任何参数,调用之后直接返回用户表总记录数。
实例2:IN + OUT 参数组合(最常用)
场景:传入用户等级,自动统计该等级下一共有多少用户,把数量通过OUT参数返回。
DELIMITER //
CREATE PROCEDURE sp_get_user_by_level(IN p_level INT, OUT p_total INT)
BEGIN
 -- 根据传入等级,统计数量,存入输出变量p_total
 SELECT COUNT(*) INTO p_total FROM `user` WHERE level = p_level;
END //
DELIMITER ;
IN p_level INT:调用时传入等级数字,用来做查询条件OUT p_total INT:执行完成之后,用户总数会存到这个变量里,供外部读取
实例3:INOUT 参数实战
场景:传入一个数字,在存储过程内部把数字乘以2,返回新数值。
DELIMITER //
CREATE PROCEDURE sp_inout_demo(INOUT p_num INT)
BEGIN
 SET p_num = p_num * 2;
END //
DELIMITER ;
调用的时候,变量既要带入初始值,又要接收计算之后的结果。
查看数据库里已有的存储过程
写好之后,可以查看存储过程列表,或者查看完整创建语句。
查询当前数据库所有存储过程
SHOW PROCEDURE STATUS WHERE Db = 'test_db';
test_db 替换成你自己的数据库名称。这条语句会展示存储过程名称、创建时间、字符集等信息。
查看存储过程完整创建代码
SHOW CREATE PROCEDURE sp_get_user_by_level;
适合时间久了,忘记存储过程内部逻辑的时候查看源码。
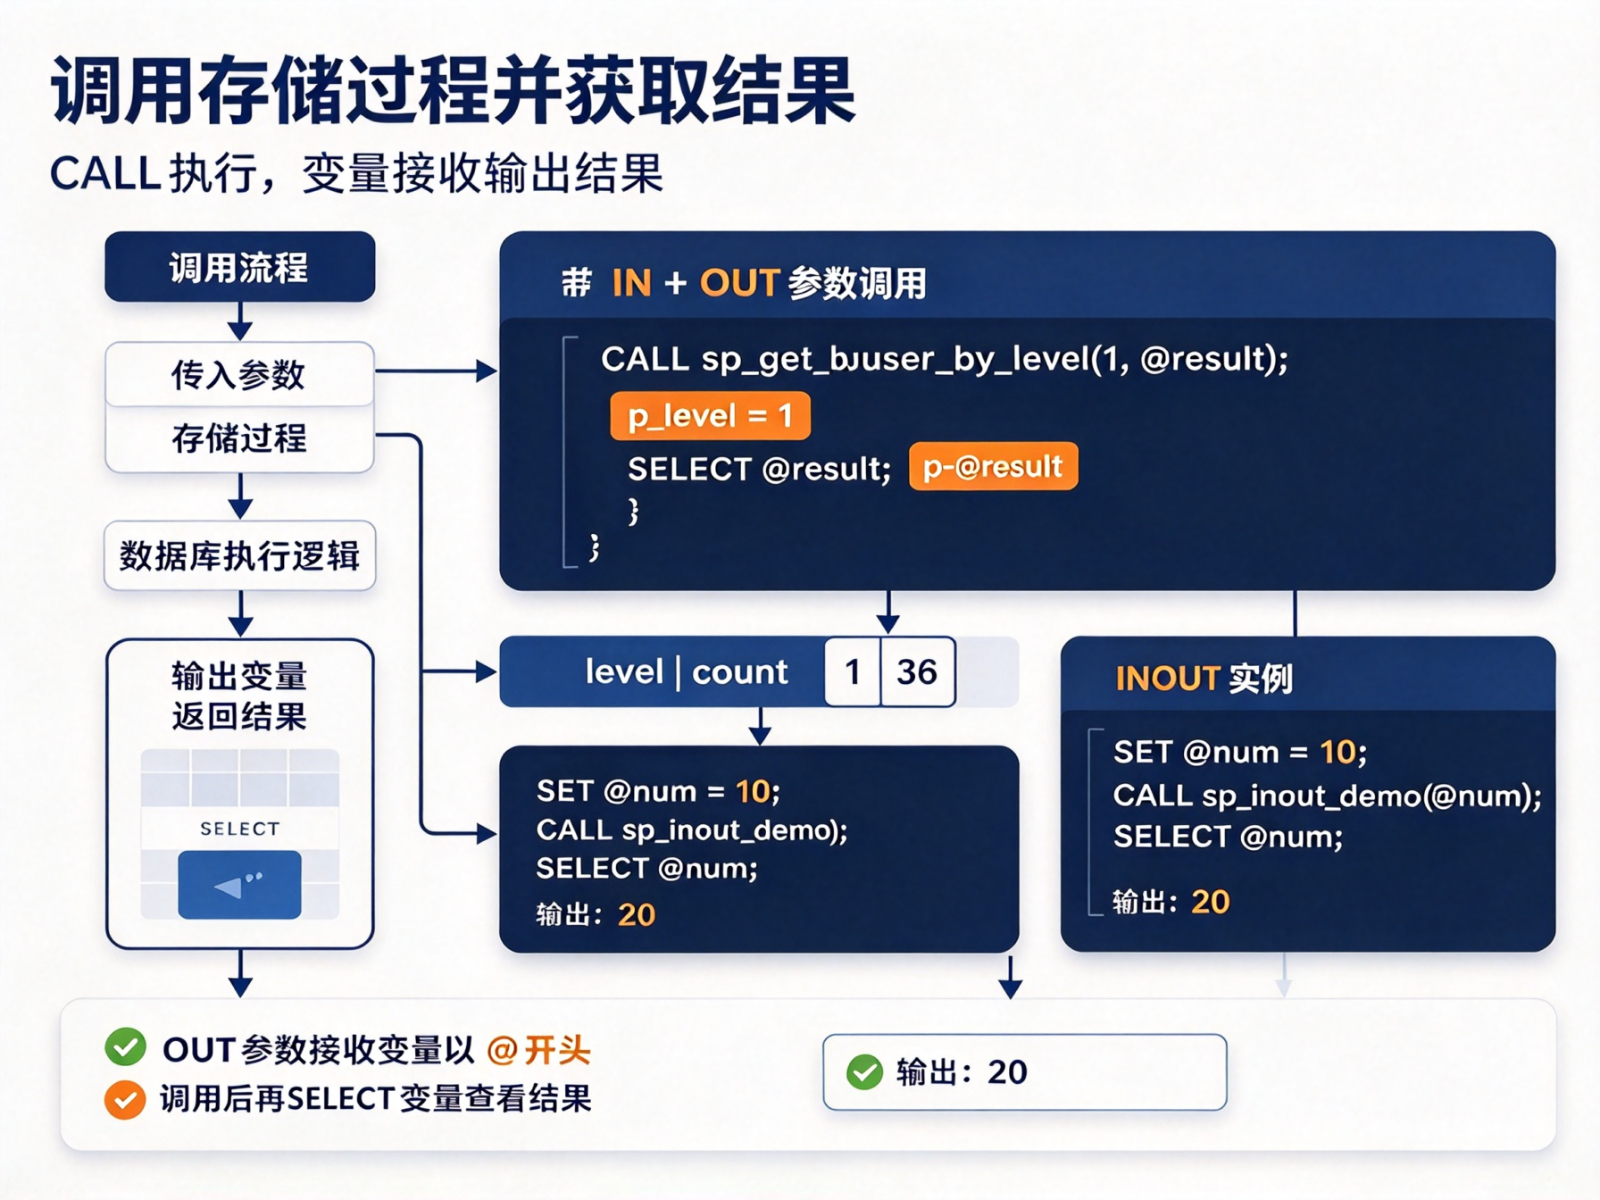
三、调用存储过程:CALL关键字实战
所有存储过程统一使用 CALL 关键字调用。
调用无参存储过程
CALL sp_count_user();
执行之后,直接返回查询结果,和直接运行SELECT效果一样。
调用带IN、OUT参数存储过程
OUT参数不能直接写数字常量,必须使用MySQL用户变量接收,变量以@开头。
-- 调用存储过程,传入等级1,统计结果存入@res
CALL sp_get_user_by_level(1,@res);
-- 读取输出变量的值
SELECT @res;
执行流程:
把数字1传给p_level(IN参数)
存储过程内部统计level=1的用户数量
将数量赋值给OUT参数p_total
p_total的值传递给外部变量@res
SELECT @res,查看最终统计数字
调用INOUT参数存储过程
-- 设置初始值10,存入@num
SET @num = 10;
-- 调用存储过程
CALL sp_inout_demo(@num);
-- 查看结果,会得到20
SELECT @num;
执行流程:
@num初始值10传入存储过程p_num
内部计算 p_num =10*2 =20
INOUT会把修改后的20传回外部@num变量
四、存储过程内部:变量、判断、循环、异常捕获
稍微复杂一点的业务,单纯SELECT不够用,存储过程支持局部变量、if判断、while循环、异常捕获。
局部变量 DECLARE
DECLARE 用来声明局部变量,只在当前 BEGIN ... END 代码块内生效,离开这个代码块就失效。
重点规则:DECLARE 必须写在 BEGIN 的第一行区域,不能放在IF、循环语句后面,否则直接报错。
示例:
DELIMITER //
CREATE PROCEDURE sp_var_demo()
BEGIN
 -- 声明局部变量,设置默认值
 DECLARE v_name VARCHAR(50) DEFAULT '';
 DECLARE v_count INT DEFAULT 0;

 -- 变量赋值方式1:SET
 SET v_count = 100;
 -- 变量赋值方式2:SELECT ... INTO
 SELECT username INTO v_name FROM `user` WHERE id = 1;

 -- 输出查看变量
 SELECT v_name, v_count;
END //
DELIMITER ;
IF条件判断
场景:根据用户数量,判断数据规模,输出提示文字。
DELIMITER //
CREATE PROCEDURE sp_if_demo(IN p_count INT)
BEGIN
 IF p_count > 100 THEN
 SELECT '数据量超标';
 ELSEIF p_count > 10 THEN
 SELECT '数据量中等';
 ELSE
 SELECT '数据量很小';
 END IF;
END //
DELIMITER ;
调用测试:
CALL sp_if_demo(120);
WHILE循环语句
场景:循环累加数字,计算从1到传入数字的总和。
DELIMITER //
CREATE PROCEDURE sp_while_demo(IN p_max INT, OUT p_sum INT)
BEGIN
 DECLARE v_i INT DEFAULT 1;
 SET p_sum = 0;
 WHILE v_i <= p_max DO
 SET p_sum = p_sum + v_i;
 SET v_i = v_i + 1;
 END WHILE;
END //
DELIMITER ;
调用测试:
CALL sp_while_demo(10,@sum);
SELECT @sum; -- 输出55
异常处理 DECLARE HANDLER
执行SQL的时候有可能出错,比如查询数据不存在、主键冲突。DECLARE HANDLER 用来捕获异常,避免整个存储过程直接中断。
示例:捕获找不到数据的异常,返回提示:
DELIMITER //
CREATE PROCEDURE sp_handler_demo(IN p_uid INT)
BEGIN
 -- 如果查询不到数据,触发这个处理器
 DECLARE EXIT HANDLER FOR NOT FOUND
 BEGIN
 SELECT '没有找到对应用户';
 END;

 SELECT username FROM `user` WHERE id = p_uid;
END //
DELIMITER ;
调用 CALL sp_handler_demo(9999),如果id=9999不存在,不会抛出错误,而是返回提示文字。

五、删除存储过程
MySQL没有直接修改存储过程的命令 ALTER PROCEDURE,如果要修改存储过程逻辑,只能先删除旧的,再重新创建新版本。
删除语法:
DROP PROCEDURE [IF EXISTS] 存储过程名;
加上 IF EXISTS 是好习惯:当存储过程不存在的时候,不会抛出错误,批量脚本执行更稳定。
示例:
DROP PROCEDURE IF EXISTS sp_get_user_by_level;
六、存储过程优缺点,什么时候该用,什么时候尽量避免
存储过程优点
SQL逻辑复用:相同统计、批量操作逻辑,多个项目、多个接口都可以调用,不用重复写SQL。
减少网络传输开销:应用只发送一条CALL命令,多条SQL逻辑在数据库内部执行,不用来回传输大量SQL文本。
精细化权限控制:可以不给开发账号开放表的直接读写权限,只允许调用指定存储过程,提升数据安全。
事务打包方便:批量新增、更新操作,可以直接在存储过程内部开启事务,保证一批数据同时成功或者回滚。
存储过程缺点
调试困难:MySQL原生没有断点调试工具,存储过程逻辑复杂时,排查BUG比较麻烦。
业务逻辑耦合在数据库:业务代码一部分写在程序里,一部分写在数据库存储过程,维护人员需要同时维护两处代码。项目迁移数据库版本时,存在兼容性风险。
数据库压力上升:大量计算逻辑放在MySQL服务端,高并发场景下,会消耗数据库CPU和内存,容易成为性能瓶颈。
版本管理麻烦:存储过程保存在数据库,不像代码文件可以直接用Git做版本管理,变更记录不好追溯。
✅ 推荐使用场景:
固定周期批量数据统计、报表生成
跨表批量数据同步、历史数据归档
逻辑固定,多系统共用的数据操作
❌ 不推荐场景:
业务频繁变动的核心业务逻辑
超高并发接口,数据库本身压力很大
需要频繁调试、迭代的业务
七、新手高频踩坑汇总
忘记修改DELIMITER分隔符:创建存储过程报语法错误,90%新手都是这个问题。写完一定要恢复
DELIMITER ;。参数名称和数据表字段同名:例如参数写
IN p_level INT,字段也叫level,容易出现查询条件被覆盖,统计结果异常。OUT参数传常量:调用OUT参数时,不能直接写数字字符串,必须使用
@开头的用户变量接收结果。DECLARE局部变量位置错误:局部变量声明必须放在BEGIN之后最前面,不能写在IF、循环后面。
存储过程创建成功,但调用返回空:大概率是查询条件写错,或者OUT变量没有正确赋值。
修改存储过程使用ALTER:MySQL不支持直接修改存储过程主体,只能DROP之后重新CREATE。